
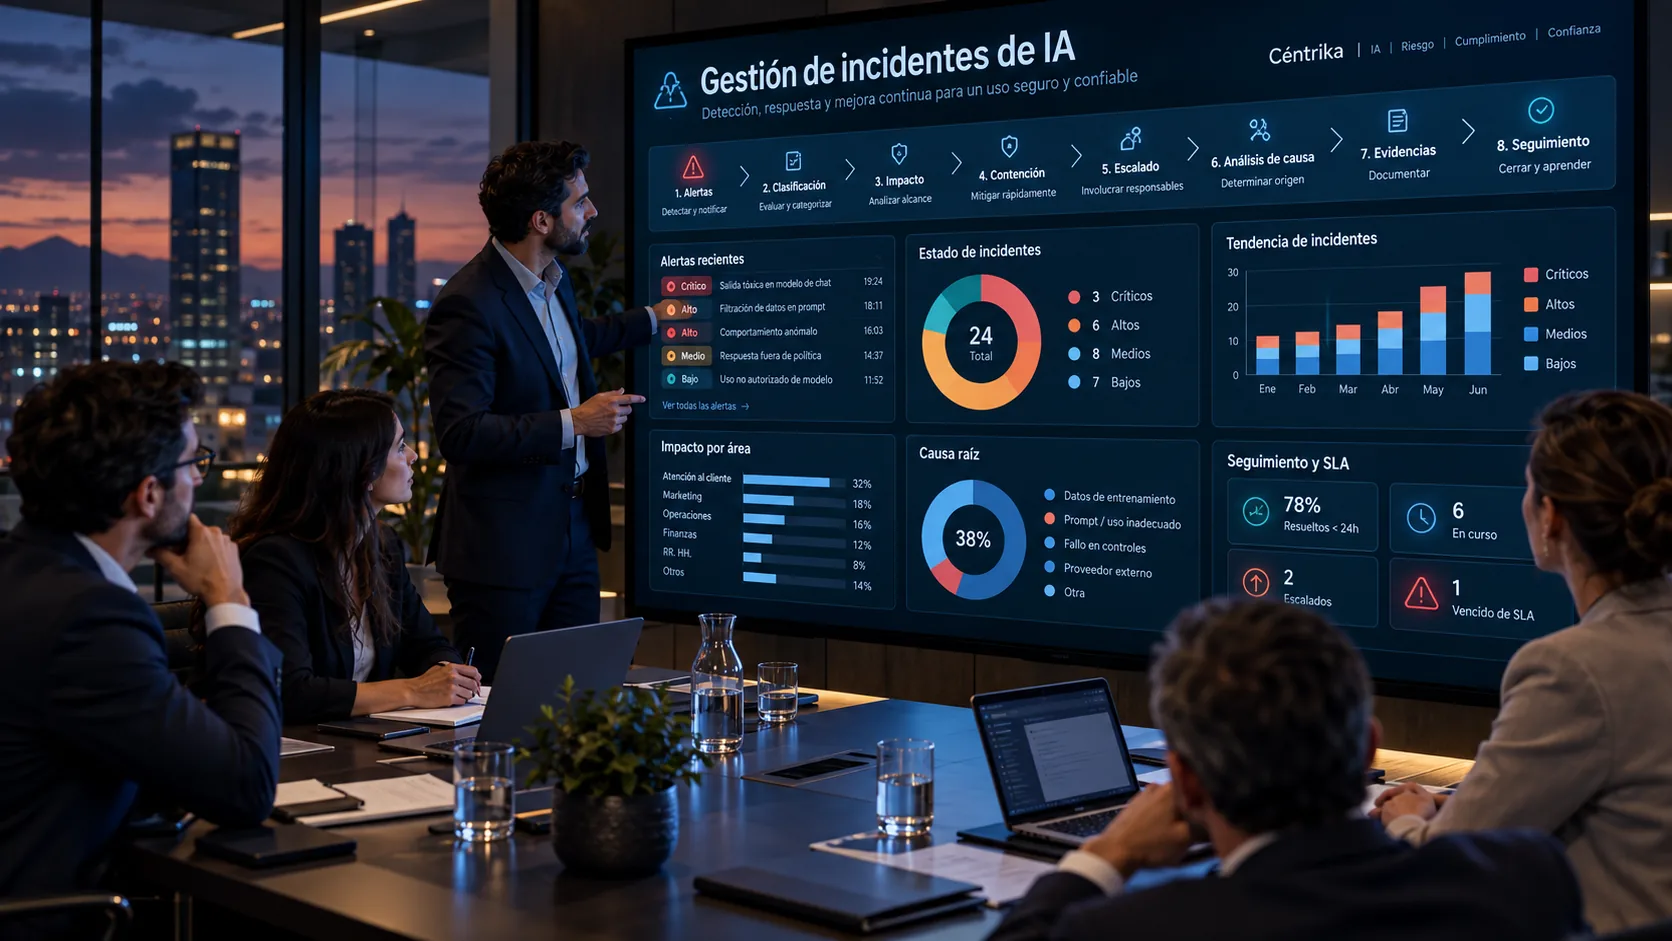
Qué es un incidente de IA
En la práctica, un incidente es un evento no deseado relacionado con un sistema de IA que exige investigar su funcionamiento o sus efectos. Puede ser una salida errónea, una filtración, un sesgo relevante, la caída de un servicio, un uso fuera de finalidad, una alteración no autorizada o un fallo de supervisión humana. El proceso interno debe abarcar daños potenciales para personas, datos, seguridad, operaciones y cumplimiento, aunque no haya obligación de comunicarlo a una autoridad.
Incidente operativo e incidente grave no son lo mismo
La categoría incidente operativo puede incluir una desviación menor que se corrige antes de causar daño. En cambio, el artículo 3.49 del AI Act consolidado define incidente grave como un incidente o funcionamiento defectuoso de un sistema de IA que provoque, directa o indirectamente: a) muerte o daños graves para la salud de una persona; b) perturbación grave e irreversible de la gestión o el funcionamiento de infraestructuras críticas; c) incumplimiento de obligaciones del Derecho de la Unión destinadas a proteger derechos fundamentales; o d) daños graves a bienes o al medio ambiente.
La gravedad interna «alta» o «crítica» no equivale por sí sola a esta definición legal. Una respuesta incorrecta tampoco basta automáticamente: importa el resultado y la relación causal, directa o indirecta, con el sistema.
Cuándo existe obligación de notificación
El artículo 73.1 exige a los proveedores de sistemas de IA de alto riesgo introducidos en el mercado de la Unión notificar los incidentes graves a las autoridades de vigilancia del mercado de los Estados miembros en que se produzcan. No convierte cada fallo de cualquier herramienta en notificable. Existen reglas sectoriales especiales: en ciertos sistemas del anexo III de proveedores sujetos a obligaciones equivalentes y en determinados productos sanitarios, el artículo 73.9 y 73.10 limita esta notificación a incidentes del artículo 3.49.c; en los supuestos del artículo 75.1a sometidos a competencia de la Oficina de IA cambia la autoridad destinataria. Comprobar la categoría del producto y el marco aplicable.
Calendario: el Reglamento se aplica en términos generales desde el 2 de agosto de 2026, pero el capítulo III, secciones 1 a 3, relativo a los sistemas de alto riesgo, tiene fechas posteriores: 2 de diciembre de 2027 para el artículo 6.2/anexo III y 2 de agosto de 2028 para el artículo 6.1/anexo I. Las disposiciones transitorias también pueden importar. Preparar un proceso ahora es buena práctica; la exigibilidad concreta requiere comprobar el supuesto y su fecha.
Plazos del artículo 73
| Supuesto, si procede la notificación del artículo 73 | Momento y límite máximo |
|---|---|
| Regla general | Inmediatamente tras establecer el nexo causal o su probabilidad razonable; en todo caso, 15 días desde que proveedor o, en su caso, responsable del despliegue conoce el incidente grave |
| Infracción generalizada o perturbación grave e irreversible de infraestructura crítica, artículo 3.49.b | Inmediatamente y, como máximo, 2 días desde ese conocimiento |
| Fallecimiento | Inmediatamente desde que se establece o sospecha el nexo causal; como máximo, 10 días desde ese conocimiento |
Los plazos de dos y diez días son reglas especiales, no plazos adicionales. Si hace falta para cumplirlos, el artículo 73.5 permite una comunicación inicial incompleta seguida de una completa. Registrar el momento en que cada actor conoció el hecho es esencial.
Quién detecta, escala y notifica
| Actor | Función según el caso |
|---|---|
| Usuario u operador | Detecta, preserva información y avisa internamente |
| Responsable del despliegue de sistema de alto riesgo | Monitoriza según instrucciones; si identifica incidente grave, informa inmediatamente primero al proveedor y después al importador o distribuidor y a las autoridades de vigilancia pertinentes conforme al artículo 26.5 |
| Proveedor de sistema de alto riesgo | Analiza causalidad, notifica según artículo 73 cuando procede, investiga y adopta medidas correctivas |
| Riesgos, Compliance, Legal o DPO | Ayudan a evaluar impacto, deberes concurrentes y evidencias |
| IT, Seguridad y negocio | Contienen el evento, restauran el proceso y verifican resultados |
Si el responsable del despliegue no puede contactar al proveedor, el artículo 26.5 remite al artículo 73 *mutatis mutandis*. Los artículos 16 y 20 establecen deberes de proveedores sobre conformidad, correcciones e información en sus supuestos; una empresa que solo utiliza un sistema no asume automáticamente esos deberes. Importadores y distribuidores conservan sus propios papeles y son destinatarios de la comunicación del responsable del despliegue indicada arriba.
De la detección al cierre: flujo operativo
| Fase | Decisión o registro útil |
|---|---|
| 1. Detección | Recibir alerta, reclamación, aviso humano o señal del proveedor |
| 2. Registro | Fechar y asociar sistema, versión, proceso y fuente |
| 3. Clasificación | Valorar urgencia interna y comprobar por separado el umbral legal |
| 4. Impacto | Identificar personas, derechos, datos, operaciones y terceros |
| 5. Contención | Limitar el daño de forma proporcionada |
| 6. Escalado | Activar responsables y valorar comunicaciones obligatorias |
| 7. Investigación | Reconstruir hechos, cambios y posibles causas |
| 8. Corrección | Restaurar el servicio y prevenir recurrencia |
| 9. Evidencias | Conservar decisiones y soportes pertinentes |
| 10. Seguimiento | Validar el resultado y vigilar nuevos síntomas |
| 11. Cierre | Registrar aceptación del riesgo residual y responsables |
| 12. Aprendizaje | Actualizar controles, umbrales y formación |
La secuencia es una propuesta operativa adaptable. La monitorización posterior al despliegue detecta señales; la gestión de incidentes coordina la respuesta: monitorización → señal → incidente → investigación → acción → mejora.
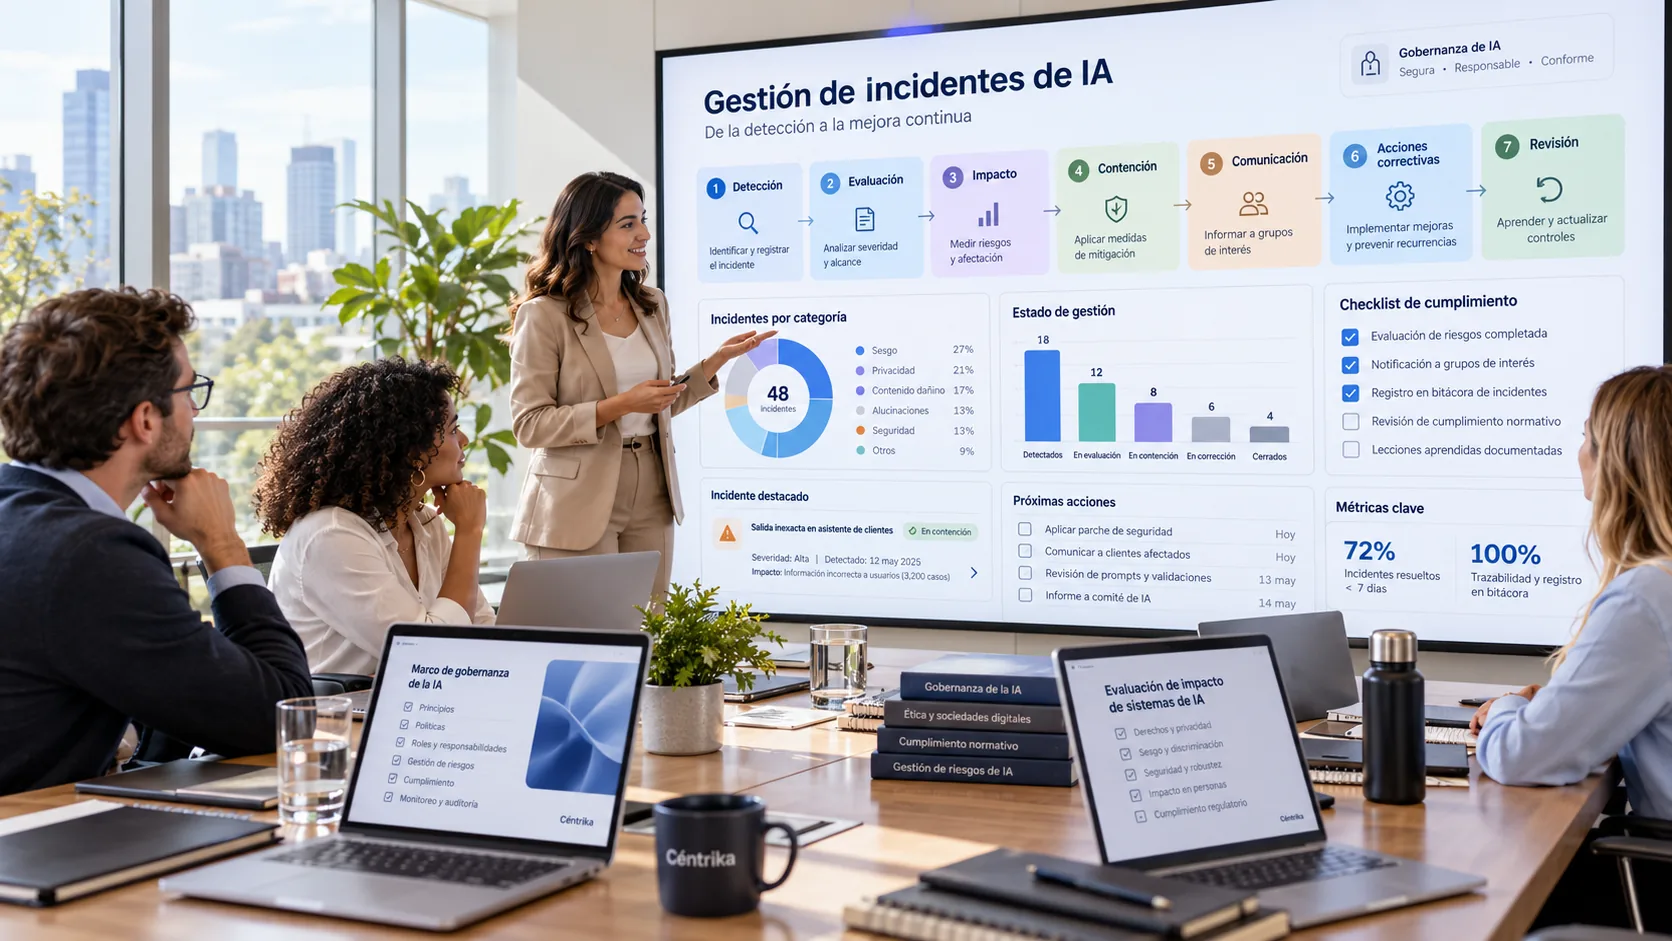
Detectar, registrar y clasificar
Alertas, KPIs y KRIs, registros técnicos, auditorías, reclamaciones, intervención humana y comunicaciones del proveedor pueden revelar problemas. En la apertura, recoger fecha y hora del hallazgo, sistema, versión, proveedor, proceso, persona que detecta, descripción, personas y datos posiblemente afectados, evidencia inicial y medidas inmediatas. Esta ficha es una buena práctica; no es un formulario universal impuesto por el AI Act.
Una escala interna baja, media, alta o crítica puede considerar alcance, duración, reversibilidad, impacto personal, seguridad, datos y continuidad. Documentar por separado si concurren los elementos jurídicos del artículo 3.49 y quién decide el escalado. Si se trata de un sistema de alto riesgo, su clasificación y rol importan.
Contener y valorar el impacto
Según el riesgo, cabe restringir una función, aumentar revisión humana, revertir configuración, aislar una integración, bloquear determinados resultados, usar una vía alternativa o solicitar apoyo al proveedor. No siempre procede desconectar todo el servicio. Priorizar la protección de las personas y conservar pruebas antes de alteraciones que puedan dificultar la investigación; en el supuesto del artículo 73.6 el proveedor debe informar a las autoridades antes de alterar el sistema de modo que pueda afectar a la evaluación posterior de las causas.
Analizar decisiones afectadas, derechos, datos, seguridad, terceros, reputación y continuidad. Una evaluación de impacto, una FRIA o una EIPD del RGPD existentes pueden necesitar revisión según contexto y requisitos. Un incidente de IA puede coincidir con una violación de datos personales o un incidente de ciberseguridad, pero son categorías diferentes con posibles vías de notificación independientes. Ataques, *prompt injection*, manipulación de datos o accesos indebidos requieren coordinación con Seguridad.
Investigar causas, proveedores y trazabilidad
El síntoma es lo observado: por ejemplo, más respuestas erróneas. La causa puede ser una versión, datos nuevos, *drift*, configuración, *prompt*, integración, controles insuficientes, uso inadecuado o varios factores a la vez. Una cronología, comparación de versiones, revisión de datos y técnica de «cinco porqués» ayudan a formular y comprobar hipótesis; ninguna es obligatoria de forma universal.
Los logs y la trazabilidad ayudan a reconstruir entrada → salida → versión → fecha → intervención → decisión, con protección de datos y sin imponer idénticos registros a todo sistema. Revisar si la supervisión existía, se usó y permitía intervenir, o si se ignoraron alertas por exceso de confianza en la IA. Ante un servicio de terceros, el contrato y la gestión de proveedores deben facilitar contactos, escalado, acceso a evidencias, análisis, corrección y responsabilidades.
Corregir, reevaluar y aprender
Corrección inmediata: revertir la configuración defectuosa. Acción correctiva: cambiar la validación de versiones para evitar que se repita. Mejora preventiva: incorporar una alerta sobre respuestas anómalas. Verificar cada medida y su eficacia con ejemplos reales.
Un incidente significativo puede activar incidente → [reevaluación de riesgos](/recursos/gestion-riesgos-ia) → riesgo residual actualizado → controles revisados. Revisar probabilidad, impacto, responsables y tratamiento. Para sistemas de alto riesgo, el artículo 9 establece un proceso continuo e iterativo; el proveedor también debe investigar, evaluar riesgos y corregir tras la notificación conforme al artículo 73.6, y atender el artículo 20 si aprecia falta de conformidad o un riesgo en sus condiciones.
Indicadores útiles, sin lista legal universal: número y severidad de incidentes, tiempos de detección y respuesta, recurrencia, porcentaje con causa investigada, concentración por sistema o proveedor e intervenciones humanas. Conectarlos con KPIs y KRIs de gobierno permite mejorar umbrales.
Qué debería conservarse
Según el caso: aviso o reclamación, alerta, muestra de entrada y salida si su tratamiento es lícito, logs, versión, cronología, evaluación inicial, clasificación interna y jurídica, decisión de escalado, comunicaciones, contención, investigación, causas, corrección, validación y cierre. Limitar acceso, preservar integridad y aplicar plazos de conservación adecuados.
Son evidencias organizativas recomendables, no una lista legal obligatoria idéntica para toda empresa. Los proveedores y responsables del despliegue de sistemas de alto riesgo tienen obligaciones específicas de información, registros y cooperación según su función y supuesto; las evidencias de IA ayudan a demostrar lo que se hizo.
Ejemplo empresarial: asistente de atención
Una empresa utiliza un asistente para ayudar al equipo de atención al cliente. Las alertas y reclamaciones muestran un aumento de respuestas incorrectas que podrían inducir a error. Se abre un incidente, se marca «alto» en la escala interna y se limita temporalmente una función; el equipo humano revisa las respuestas afectadas.
Se conservan las entradas pertinentes conforme a protección de datos, salidas, versiones, configuración y registros. La investigación identifica un cambio de configuración reciente, se revierte, se valida con muestras y se añade un control previo a futuros cambios. Quedan documentados el responsable, las decisiones, el proveedor y la comprobación posterior.
La empresa analiza aparte si su sistema es de alto riesgo, qué rol desempeña y si hubo alguna consecuencia incluida en el artículo 3.49. Un aumento de respuestas incorrectas no implica por sí solo incidente grave ni notificación bajo el artículo 73; si hay violación de datos personales u otra obligación sectorial, se examina por su propia vía.
Gestión de incidentes e ISO/IEC 42001
ISO/IEC 42001 aporta estructura para asignar roles, registrar desviaciones, revisar el desempeño y comprobar acciones correctivas y mejora continua. ISO/IEC 23894 puede ayudar a integrar las lecciones en la gestión de riesgos de IA. Son marcos de apoyo: un proceso de sistema de gestión no sustituye los requisitos, destinatarios y plazos jurídicos del artículo 73.
Conclusión
Una respuesta útil une hechos, personas, decisiones y evidencias. Definir el circuito antes de un problema permite actuar con proporcionalidad; comprobar por separado la definición legal, el rol, el sistema y la fecha aplicable evita notificaciones innecesarias y omisiones relevantes.
¿Sabría tu organización responder a un incidente de IA?
Define responsables, escalado, controles y evidencias antes de que surja un problema.
Realizar diagnóstico →
El diagnóstico de Céntrika ayuda a identificar brechas en el gobierno y los riesgos de IA.